 PTH Market

سوئیچی با سرعت ۷.۲ ترابایت در ثانیه؛ انویدیا چگونه مرز انتقال داده را جابهجا کرد؟
سوئیچ NVLink انویدیا چگونه به پهنای باند ۷.۲ ترابایت بر ثانیه رسید؟ بررسی فناوری، کاربرد در هوش مصنوعی و نسلهای Blackwell و Vera Rubin.
تصور کنید مجموعهای از قدرتمندترین پردازندههای گرافیکی جهان مشغول آموزش یک مدل عظیم هوش مصنوعی هستند. هر پردازنده میلیونها عملیات انجام میدهد، اما برای ادامه کار باید اطلاعات را با پردازندههای دیگر به اشتراک بگذارد.
حالا اگر این اطلاعات بهاندازه کافی سریع منتقل نشوند، چه اتفاقی میافتد؟
حتی پردازندههای فوققدرتمند نیز ممکن است بخشی از زمان خود را منتظر رسیدن دادهها بمانند.
اینجاست که فناوری NVIDIA NVLink Switch اهمیت پیدا میکند؛ سامانهای ارتباطی که در نسل چهارم خود به پهنای باند تجمیعی ۷.۲ ترابایت بر ثانیه رسید و مسیر توسعه ارتباطات پرسرعت میان پردازندههای هوش مصنوعی را هموار کرد.
اما نکته جالبتر این است که عدد ۷.۲ ترابایت دیگر پایان ماجرا نیست. انویدیا در نسلهای جدید Blackwell و Vera Rubin ظرفیت ارتباطی را به سطوح بسیار بالاتری رسانده است.
۷.۲ ترابایت در یک ثانیه؛ این عدد چقدر بزرگ است؟
برای درک بهتر، فرض کنید هر فیلم با کیفیت 4K حجمی معادل ۲۰ گیگابایت داشته باشد.
در این صورت، ۷.۲ ترابایت تقریباً معادل حجم ۳۶۰ فیلم خواهد بود.
یعنی پهنای باند تجمیعی اعلامشده برای دامنه هشتپردازندهای NVLink نسل چهارم، از نظر عددی با جابهجایی چنین حجمی در هر ثانیه قابل مقایسه است. این تشبیه فقط برای درک مقیاس عدد است؛ یک انتقال واقعی به این سرعت نمیرسد.
البته یک تفاوت مهم وجود دارد.
این عدد سرعت دانلود اینترنت یا انتقال فایل از یک کامپیوتر معمولی به کامپیوتر دیگر نیست.
رقم ۷.۲ ترابایت بر ثانیه، پهنای باند تجمیعی ارتباطات داخلی یک سامانه پردازشی است. در واقع، مجموع ظرفیت مسیرهای ارتباطی مشخص میان پردازندهها را نشان میدهد.
سرعت واقعی یک انتقال منفرد میتواند بسیار کمتر باشد و به ساختار ارتباط، نرمافزار و شرایط پردازش بستگی دارد.
NVLink Switch چیست و چه کاری انجام میدهد؟
برای درک کاربرد این فناوری، باید ابتدا بدانیم پردازندههای گرافیکی چگونه در اجرای مدلهای بزرگ هوش مصنوعی همکاری میکنند.
وقتی یک مدل هوش مصنوعی بسیار بزرگ باشد، ممکن است اجرای آن روی یک پردازنده گرافیکی امکانپذیر یا مقرونبهصرفه نباشد.
در چنین شرایطی، بخشهای مختلف محاسبات میان چندین GPU تقسیم میشوند.
اما این تقسیم کار مسئله تازهای ایجاد میکند: پردازندهها باید مرتب نتایج محاسبات و اطلاعات موردنیاز را با یکدیگر مبادله کنند.
اگر این ارتباط کند باشد، افزایش تعداد پردازندهها الزاماً باعث افزایش متناسب سرعت پردازش نمیشود.
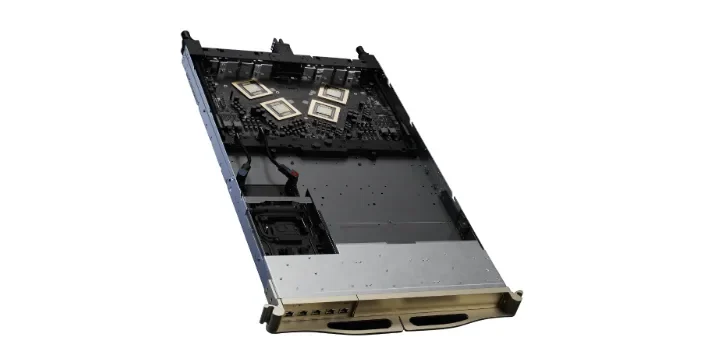
طبق مشخصات رسمی NVIDIA NVLink و NVLink Switch، فناوری NVLink برای ارتباط پرسرعت میان GPUها توسعه یافته است و NVLink Switch امکان اتصال تعداد بیشتری از آنها را فراهم میکند.
به زبان ساده، NVLink مسیر ارتباطی است و NVLink Switch به ایجاد شبکه ارتباطی میان پردازندههای گرافیکی کمک میکند.
این ارتباط سختافزاری در کنار لایه نرمافزاری پردازش قرار میگیرد؛ برای آشنایی با آن لایه، نقش CUDA در اجرای محاسبات هوش مصنوعی روی GPU را بخوانید.
به کمک این معماری، چندین پردازنده گرافیکی میتوانند با پهنای باند بالا و تأخیر کم با یکدیگر همکاری کنند.
چرا شبکههای معمولی برای هوش مصنوعی کافی نیستند؟
در شبکههای متداول کامپیوتری، دستگاهها از طریق فناوریهایی مانند Ethernet اطلاعات را مبادله میکنند.
این فناوریها برای ارتباط میان سرورها، تجهیزات ذخیرهسازی و زیرساختهای شبکه بسیار مهماند و خودشان نیز به سرعتهای فوقالعاده بالایی رسیدهاند.
اما ارتباط نزدیک و مداوم میان دهها GPU در یک سامانه هوش مصنوعی، نیازهای متفاوتی دارد.
برای مثال، در آموزش بعضی مدلهای بزرگ، پردازندهها باید اطلاعات مربوط به نتایج محاسبات را بارها با یکدیگر هماهنگ کنند.
این فرایند به پهنای باند بالا، تأخیر کم و ارتباط قابلاعتماد نیاز دارد.
NVLink Switch برای همین نوع ارتباط داخلی طراحی شده است.
البته این موضوع به معنی حذف Ethernet یا InfiniBand از دیتاسنترها نیست. این فناوریها همچنان برای اتصال سامانههای پردازشی، سرورها و بخشهای مختلف مراکز داده نقش مهمی دارند.
در واقع، NVLink و شبکههای دیتاسنتری متداول بیشتر مکمل یکدیگر هستند تا جایگزین کامل هم.
از ۷.۲ ترابایت تا ۱۳۰ ترابایت در ثانیه!
رقم ۷.۲ ترابایت بر ثانیه در جدول رسمی انویدیا به پهنای باند تجمیعی دامنه هشتپردازندهای NVLink نسل چهارم در معماری Hopper اشاره دارد؛ این رقم سرعت یک سوئیچ منفرد نیست.
اما با معرفی نسل Blackwell، انویدیا امکان اتصال تعداد بیشتری پردازنده گرافیکی را در یک مجموعه پردازشی فراهم کرد.
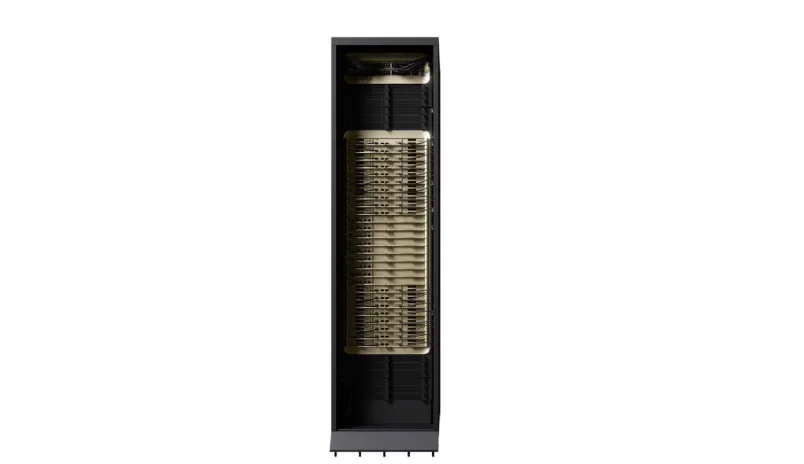
در معماری NVIDIA GB200 NVL72، تعداد ۷۲ پردازنده گرافیکی Blackwell با کمک نسل پنجم NVLink به یکدیگر متصل میشوند.
طبق مشخصات رسمی انویدیا، پهنای باند تجمیعی این مجموعه به حدود ۱۳۰ ترابایت بر ثانیه میرسد.
این عدد نشان میدهد که توسعه زیرساختهای هوش مصنوعی تنها به افزایش قدرت محاسباتی تراشهها محدود نیست؛ ارتباط سریع میان آنها نیز به همان اندازه اهمیت دارد.
در چنین معماریهایی، هدف این است که مجموعه بزرگی از GPUها بتواند تا حد امکان مانند یک سامانه پردازشی واحد فعالیت کند.
نکته مهم آن است که عدد ۱۳۰ ترابایت برای کل مجموعه NVL72 بیان میشود و نباید آن را با ظرفیت یک پورت یا سرعت یک اتصال منفرد اشتباه گرفت.
تکامل پهنای باند تجمیعی NVIDIA NVLink
Hopper · ۸ GPUNVLink 5
Blackwell NVL72 · ۷۲ GPUNVLink 6
Vera Rubin NVL72 · ۷۲ GPU
| نسل | معماری و دامنه | پهنای باند تجمیعی |
|---|---|---|
| NVLink 4 | Hopper، ۸ GPU | ۷٫۲ TB/s |
| NVLink 5 | Blackwell NVL72، ۷۲ GPU | ۱۳۰ TB/s |
| NVLink 6 | Vera Rubin NVL72، ۷۲ GPU | ۲۱۶ TB/s |
نسل تازه Vera Rubin؛ یک جهش دیگر در ارتباط GPUها
انویدیا در نسل ششم NVLink که برای پلتفرم Vera Rubin توسعه داده شده، این مسیر را ادامه داده است.
در مشخصات رسمی NVIDIA Vera Rubin NVL72 و نسخه آمریکایی جدول NVLink، پهنای باند ارتباطی هر GPU در این نسل ۳ ترابایت بر ثانیه و ظرفیت تجمیعی پیکربندی NVL72 برابر با ۲۱۶ ترابایت بر ثانیه اعلام شده است.
در نسخه اروپایی مشخصات NVLink و مطلب فنی NVIDIA درباره Vera Rubin POD، برای نسل ششم عدد ۳.۶ ترابایت بر ثانیه برای هر GPU و حدود ۲۶۰ ترابایت بر ثانیه برای مجموعه NVL72 آمده است.
این اختلاف نشان میدهد هنگام گزارش مشخصات نسل جدید، باید نسخه صفحه، تاریخ بررسی و مقدماتیبودن اعداد را روشن بیان کرد.
اما روند کلی مشخص است: افزایش قابلتوجه ظرفیت ارتباط میان پردازندههای هوش مصنوعی.
این موضوع برای مدلهای بسیار بزرگ، بهویژه مدلهایی که از معماری Mixture of Experts استفاده میکنند، اهمیت دارد؛ زیرا بخشهای مختلف محاسبات ممکن است میان تعداد زیادی GPU توزیع شوند.
آیا این فناوری سرعت هوش مصنوعی را بیشتر میکند؟
پاسخ کوتاه، بله؛ اما نه بهصورت خودکار و برای تمام کارها.
وقتی بخش قابلتوجهی از زمان اجرای یک مدل صرف تبادل داده میان پردازندهها شود، افزایش پهنای باند و کاهش تأخیر ارتباطی میتواند به بهبود عملکرد کمک کند.
برای مثال، یک مدل بزرگ ممکن است برای تولید پاسخ به همکاری دهها پردازنده گرافیکی نیاز داشته باشد.
اگر اطلاعات سریعتر میان آنها منتقل شود، زمان انتظار کاهش پیدا میکند و امکان استفاده مؤثرتر از توان پردازشی فراهم میشود.
اما عملکرد نهایی همچنان به معماری مدل، تعداد GPUها، حافظه، نرمافزار، روش تقسیم محاسبات و عوامل دیگر وابسته است.
بنابراین نباید تصور کرد افزایش چندبرابری پهنای باند شبکه لزوماً سرعت پاسخگویی هوش مصنوعی را نیز به همان نسبت افزایش میدهد.
مزیت اصلی NVLink Switch این است که یکی از محدودیتهای مهم پردازش توزیعشده را کاهش میدهد.
ارتباط NVLink با ابرکامپیوترهای Vera Rubin
انویدیا برای نسل جدید Vera Rubin تنها به افزایش توان محاسباتی پردازندهها اکتفا نکرده است.
در این معماری، مدیریت ارتباط میان GPUها و طراحی سیستم خنکسازی از اجزای مهم زیرساخت محسوب میشوند.
همانطور که در گزارش مربوط به خنکسازی Vera Rubin توضیح داده شده است، انویدیا تلاش کرده سامانههای پردازشی جدید را با استفاده از خنکسازی مایع و شرایط عملیاتی متفاوت توسعه دهد.
درحالیکه سامانه سرمایشی وظیفه مدیریت گرمای تجهیزات را بر عهده دارد، NVLink Switch مسیر ارتباط سریع میان پردازندهها را فراهم میکند.
این دو فناوری وظایف متفاوتی دارند، اما هر دو بخشی از طراحی هماهنگ یک زیرساخت بزرگ هوش مصنوعی هستند.
برای بررسی بخش دیگر این زیرساخت، گزارش PTH Market درباره خنکسازی مایع Vera Rubin را بخوانید.
از دیتاسنترهای عظیم تا رباتهای کوچک
کاربرد محاسبات هوش مصنوعی تنها به چتباتها و تولید متن محدود نمیشود.
در حوزههایی مانند رباتیک، پژوهشگران از زیرساختهای پردازشی پیشرفته برای آموزش مدلها و شبیهسازی رفتارهای پیچیده استفاده میکنند.
نمونهای از این مسیر را میتوان در پروژه رباتهای Microduck مشاهده کرد؛ رباتهای کوچکی که برای آموزش رفتارهای حرکتی از محیطهای شبیهسازی و ابزارهای هوش مصنوعی استفاده میکنند.
البته این موضوع به معنای استفاده مستقیم Microduck از NVLink Switch نیست. ارتباط این دو خبر در حوزه گستردهتر زیرساختهای هوش مصنوعی و آموزش مدلهاست.
مطلب مرتبط: رباتهای Microduck در کنفرانس NVIDIA GTC 2026.
آینده ابرکامپیوترها فقط به پردازندههای سریعتر وابسته نیست
برای سالها، رقابت سختافزاری بیشتر با معیارهایی مانند سرعت پردازنده، تعداد هستهها و ظرفیت حافظه شناخته میشد.
اما رشد مدلهای هوش مصنوعی نشان داده است که توان پردازشی تنها بخشی از معادله است.
وقتی صدها یا هزاران پردازنده در یک زیرساخت فعالیت میکنند، سرعت ارتباط میان آنها میتواند بر عملکرد کل سیستم تأثیر زیادی بگذارد.
به همین دلیل، فناوریهای ارتباطی مانند NVLink Switch به یکی از اجزای اصلی طراحی ابرکامپیوترهای هوش مصنوعی تبدیل شدهاند.
این تجهیزات شاید بهاندازه تراشههای گرافیکی مشهور نباشند، اما بدون ارتباط سریع و هماهنگ، استفاده از ظرفیت عظیم پردازندههای جدید دشوارتر خواهد شد.
سوئیچی که قرار نیست روی میز کار شما باشد!
برخلاف سوئیچهای معمولی که در دفتر، شرکت یا شبکه خانگی استفاده میشوند، NVLink Switch برای ارتباط تخصصی میان پردازندههای گرافیکی طراحی شده است.
این فناوری قرار نیست مستقیماً سرعت اینترنت خانه را افزایش دهد یا دانلود فایل را سریعتر کند.
کار اصلی آن در مقیاسی متفاوت انجام میشود؛ جایی که مجموعههای عظیم پردازشی مشغول آموزش و اجرای پیچیدهترین مدلهای هوش مصنوعی هستند.
۷.۲ ترابایت در ثانیه زمانی عددی چشمگیر برای این فناوری بود، اما نسلهای بعدی نشان دادند که این تنها یکی از مراحل توسعه ارتباطات پرسرعت GPUهاست.
شاید آینده هوش مصنوعی فقط به تراشههایی وابسته نباشد که سریعتر محاسبه میکنند؛ بلکه به ارتباطاتی وابسته باشد که اجازه میدهند هزاران تراشه سریعتر با هم کار کنند.
و گاهی مهمترین قطعه یک ابرکامپیوتر، همان قطعهای است که کمتر کسی نامش را شنیده است.