 PTH Market

CUDA چیست و چرا یکی از پایههای اصلی پیشرفت هوش مصنوعی محسوب میشود؟
CUDA پلتفرم محاسبات موازی انویدیاست که اجرای محاسبات سنگین هوش مصنوعی روی GPU را ممکن میکند. در این مقاله با نحوه عملکرد، کتابخانهها، نمونهکدها و نقش آن در پیشرفت مدلهای هوش مصنوعی آشنا میشویم.
قدرت پردازندههای گرافیکی بهتنهایی نمیتواند موفقیت انویدیا در هوش مصنوعی را توضیح دهد. بخش مهمی از این موفقیت به فناوریای مربوط میشود که نزدیک به دو دهه پیش معرفی شد: CUDA.
تصور کنید هزاران پردازنده گرافیکی در یک مرکز داده مشغول آموزش یک مدل زبانی بزرگ هستند. این پردازندهها باید میلیاردها عملیات ریاضی را انجام دهند، دادهها را مدیریت کنند و نتایج محاسبات را با یکدیگر هماهنگ سازند.
اما چه چیزی به نرمافزار اجازه میدهد از توان پردازشی GPUها استفاده کند؟
اینجاست که CUDA یا Compute Unified Device Architecture نقش پیدا میکند؛ فناوریای که استفاده از کارت گرافیک را از پردازش تصویر و بازی فراتر برد و آن را به بستری برای محاسبات علمی، یادگیری ماشین و هوش مصنوعی تبدیل کرد.
CUDA چیست؟
CUDA یک پلتفرم محاسبات موازی و مدل برنامهنویسی است که شرکت NVIDIA در سال ۲۰۰۶ معرفی کرد.
پیش از آن، توسعهدهندگان برای استفاده عمومی از قدرت GPU با محدودیتهای بیشتری مواجه بودند؛ زیرا معماری و رابطهای برنامهنویسی کارتهای گرافیک عمدتاً برای وظایف گرافیکی طراحی شده بودند.
CUDA این امکان را فراهم کرد که برنامهنویسان با ابزارها و زبانهای مناسب، محاسبات غیرگرافیکی را نیز روی پردازندههای گرافیکی انویدیا اجرا کنند.
امروزه این پلتفرم تنها یک رابط برنامهنویسی نیست؛ بلکه مجموعهای از کامپایلرها، کتابخانههای محاسباتی، ابزارهای اشکالزدایی، محیط اجرای برنامه و امکانات بهینهسازی را شامل میشود.
طبق راهنمای رسمی برنامهنویسی CUDA، کاربردهای CUDA از یادگیری عمیق تا شبیهسازی علمی و محاسبات سنگین گسترش یافته است.
تفاوت CPU، GPU و CUDA در چیست؟
برای فهم جایگاه CUDA، باید سه مفهوم را از هم تفکیک کنیم.
CPU پردازندهای عمومی است که برای اجرای وظایف متنوع، کنترل جریان برنامه و انجام محاسبات پیچیده با تعداد محدودی هسته قدرتمند طراحی شده است.
GPU معماریای دارد که برای انجام تعداد زیادی محاسبه مشابه بهصورت موازی مناسب است؛ قابلیتی که در پردازش ماتریسها و شبکههای عصبی اهمیت زیادی دارد.
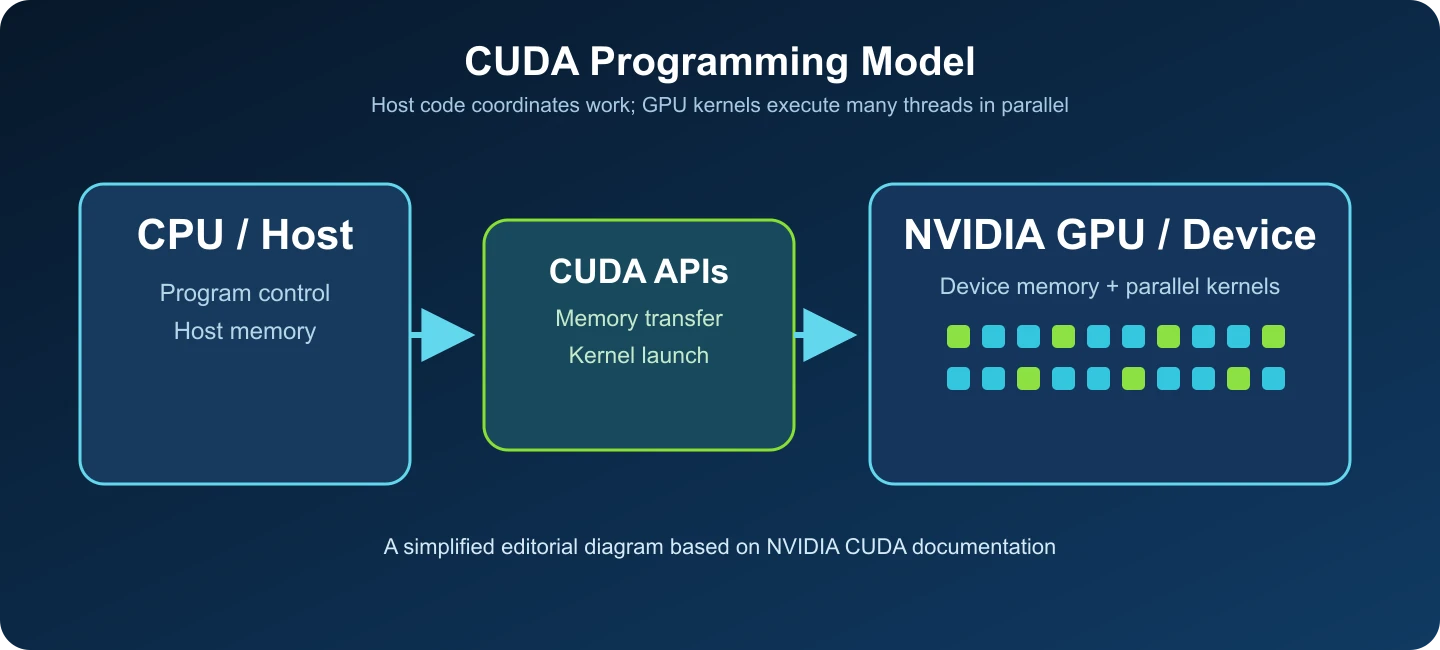
CUDA خود یک پردازنده نیست. CUDA زیرساخت نرمافزاریای است که برنامهنویسان و کتابخانهها با استفاده از آن میتوانند محاسبات مناسب را روی GPUهای سازگار انویدیا اجرا کنند.
یک مثال ساده، ضرب دو ماتریس بسیار بزرگ است. تعداد زیادی از محاسبات این مسئله قابلیت اجرای موازی دارند و یک GPU مناسب میتواند آنها را با توان عملیاتی بالایی انجام دهد.
البته نباید نتیجه گرفت که GPU همیشه از CPU سریعتر است. پردازشهای کوچک، وابستگیهای ترتیبی، جابهجایی داده و محدودیت حافظه میتوانند مزیت پردازش موازی را کاهش دهند.
CUDA چه تأثیری بر آموزش مدلهای هوش مصنوعی دارد؟
آموزش یک مدل یادگیری عمیق شامل تکرار تعداد زیادی عملیات ریاضی است. دادهها وارد مدل میشوند، خروجی تولید میشود، میزان خطا محاسبه میشود و سپس پارامترهای مدل با استفاده از گرادیانها بهروزرسانی میشوند.
این فرایند ممکن است میلیونها یا میلیاردها بار در قالب عملیات گسترده ماتریسی و برداری اجرا شود.
CUDA امکان اجرای این محاسبات را روی GPUهای انویدیا فراهم میکند و کتابخانههای تخصصی نیز پیادهسازی بهینه آنها را در اختیار چارچوبهایی مانند PyTorch قرار میدهند.
در نتیجه، برای بارهای کاری مناسب، آموزش مدلها میتواند نسبت به اجرای صرفاً مبتنی بر CPU بسیار سریعتر باشد.
اما میزان این افزایش سرعت ثابت نیست و به معماری مدل، اندازه دستههای داده، حافظه GPU، نوع عملیات و کیفیت پیادهسازی بستگی دارد.
نقش CUDA در اجرای مدلها و پاسخگویی سریعتر
کاربرد CUDA تنها به مرحله آموزش محدود نمیشود.
وقتی یک مدل آموزشدیده مورد استفاده قرار میگیرد، باید داده ورودی را پردازش و خروجی تولید کند. به این مرحله Inference یا استنتاج گفته میشود.
برای مثال، یک سیستم تشخیص تصویر ممکن است در هر ثانیه دهها تصویر را تحلیل کند یا یک مدل زبانی به درخواستهای متعدد پاسخ دهد.
اجرای بهینه این عملیات روی GPU میتواند زمان پاسخ، توان عملیاتی یا هزینه پردازش هر درخواست را بهبود دهد.
البته سرعت نهایی یک سرویس هوش مصنوعی فقط به CUDA وابسته نیست. معماری مدل، مدیریت حافظه، تعداد کاربران همزمان، شبکه ارتباطی و تنظیمات زیرساخت نیز نقش دارند.
اکوسیستم CUDA؛ مزیت واقعی انویدیا کجاست؟
بر اساس مستندات CUDA Toolkit انویدیا، CUDA طی سالها به اکوسیستمی متشکل از ابزارها و کتابخانههای تخصصی تبدیل شده است.
این کتابخانهها باعث میشوند توسعهدهندگان برای اجرای عملیات متداول، مجبور نباشند تمام الگوریتمها را از ابتدا در سطح GPU پیادهسازی کنند.
کتابخانهها و فناوریهای اصلی CUDA
| فناوری | نقش در هوش مصنوعی |
|---|---|
| CUDA | برنامهنویسی و اجرای محاسبات روی GPU |
| cuBLAS | تسریع عملیات جبر خطی و ماتریسها |
| cuDNN | بهینهسازی عملیات شبکههای عصبی |
| TensorRT | بهینهسازی اجرای مدلهای آموزشدیده |
| NCCL | ارتباط و هماهنگی پردازشها بین GPUها |
این جدول پنج بخش مهم اکوسیستم را نشان میدهد، اما همه ابزارهای CUDA را پوشش نمیدهد.
cuBLAS پیادهسازی بهینه عملیات جبر خطی، بهویژه عملیات ماتریسی، را فراهم میکند. چنین محاسباتی در بسیاری از لایههای مدلهای یادگیری ماشین استفاده میشوند.
cuDNN مجموعهای از عملیات بهینه برای آموزش و اجرای شبکههای عصبی ارائه میدهد؛ از جمله Convolution، ضرب ماتریس، Attention و ترکیب چند عملیات در یک مسیر اجرایی.
TensorRT برای بهینهسازی اجرای مدلهای آموزشدیده طراحی شده است. بسته به مدل و سختافزار، میتواند با روشهایی مانند بهینهسازی گراف و استفاده از دقت عددی مناسب، عملکرد استنتاج را بهبود دهد.
NCCL ارتباطات جمعی و تبادل داده را در محاسبات چند GPU تسهیل میکند. وقتی مدل روی چند پردازنده تقسیم میشود، هماهنگی دادهها بخش مهمی از عملکرد کل سیستم است.
ارزش این مجموعه در آن است که ابزارهای مختلف میتوانند در یک زنجیره نرمافزاری هماهنگ کار کنند.
این هماهنگی، همراه با سالها بهینهسازی و پشتیبانی از چارچوبهای رایج، یکی از مزیتهای رقابتی انویدیاست.
CUDA چگونه محاسبات هوش مصنوعی را به GPU منتقل میکند؟
این مسیر مفهومی است؛ همه برنامهها الزاماً از یک کتابخانه یا ترتیب یکسان استفاده نمیکنند.
- 1. کد برنامه یا مدل هوش مصنوعی
- 2. چارچوبی مانند PyTorch یا TensorFlow
- 3. CUDA Runtime و کتابخانههای مناسب
- 4. GPU سازگار انویدیا
- 5. اجرای موازی عملیات ماتریسی و شبکه عصبی
- 6. نتیجه محاسبات
نقش کتابخانهها: cuBLAS برای جبر خطی، cuDNN برای عملیات شبکه عصبی، TensorRT برای استنتاج و NCCL در صورت نیاز به ارتباط چند GPU به کار میروند.
CUDA چگونه در عمل به مدلهای هوش مصنوعی کمک میکند؟
طبق مستندات CUDA در PyTorch، میتوان دسترسی به GPU را بررسی و دستگاه اجرای تنسورها را انتخاب کرد. فرض کنیم یک مدل تشخیص تصویر را با PyTorch آموزش میدهیم.
برنامهنویس ابتدا مدل و دادهها را آماده میکند. سپس میتواند آنها را روی GPU سازگار قرار دهد.
PyTorch عملیات موردنیاز را اجرا میکند و برای بخشهایی از محاسبات از CUDA و کتابخانههای بهینهشده استفاده میشود.
نمونهکد اول: بررسی دسترسی به CUDA
import torch

print("CUDA available:", torch.cuda.is_available())

if torch.cuda.is_available():
    print("GPU:", torch.cuda.get_device_name(0))
else:
    print("CUDA GPU is not available in this environment.")
این نمونه نشان میدهد آیا محیط فعلی PyTorch میتواند از CUDA استفاده کند یا خیر.
نمونهکد دوم: ضرب ماتریس با CPU یا GPU
import torch

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

a = torch.randn(2048, 2048, device=device)
b = torch.randn(2048, 2048, device=device)

result = a @ b

print("Device:", device)
print("Result shape:", tuple(result.shape))
در این مثال، اگر CUDA در دسترس باشد، دو ماتریس روی GPU ساخته میشوند و عملیات ضرب آنها نیز روی GPU انجام میشود.
اگر CUDA در دسترس نباشد، برنامه به CPU برمیگردد.
این مثال، روش انتخاب دستگاه و انجام یک محاسبه را نشان میدهد؛ نه نتیجه بنچمارک سرعت.
برای اندازهگیری دقیق زمان اجرای عملیات CUDA، باید به اجرای غیرهمزمان GPU توجه کرد و از ابزارهایی مانند CUDA Events یا همگامسازی مناسب استفاده کرد.
ارتباط CUDA با NVLink و ابرکامپیوترهای هوش مصنوعی
وقتی تعداد پردازندهها افزایش مییابد، مسئله تنها اجرای سریع عملیات نیست؛ پردازندهها باید دادهها و نتایج محاسبات را نیز مبادله کنند.
در اینجا باید میان سه فناوری تفاوت قائل شویم:
CUDA: اجرای محاسبات روی GPU.
NCCL: انجام عملیات ارتباطی و هماهنگی میان GPUها.
NVLink: فناوری ارتباط سختافزاری پرسرعت میان GPUهای پشتیبانیشده.
برای مثال، در آموزش توزیعشده یک مدل بزرگ، چند GPU ممکن است بخشی از محاسبات را بهصورت موازی انجام دهند. سپس نتایج یا گرادیانها باید میان آنها هماهنگ شود.
NCCL عملیات ارتباطی مانند AllReduce و AllGather را فراهم میکند و بسته به سختافزار و توپولوژی ارتباطی میتواند از مسیرهای مناسب انتقال داده بهره ببرد.
بنابراین CUDA و NVLink رقیب یکدیگر نیستند؛ هرکدام مسئله متفاوتی را حل میکنند.
برای بررسی لایهٔ ارتباطی این سامانهها، مطلب فناوری NVLink برای ارتباط پرسرعت پردازندههای گرافیکی را بخوانید.
آیا هوش مصنوعی بدون CUDA امکانپذیر است؟
بله. این نکته برای بررسی واقعبینانه جایگاه انویدیا اهمیت دارد.
مدلهای هوش مصنوعی میتوانند روی CPU و شتابدهندههای دیگر نیز آموزش داده یا اجرا شوند.
برای مثال، AMD از اکوسیستم ROCm استفاده میکند و اپل با Metal امکان استفاده از توان پردازشی سختافزار خود را فراهم میسازد.
پردازندههای اختصاصی دیگری نیز برای محاسبات یادگیری ماشین توسعه یافتهاند.
پس مزیت انویدیا را نباید به «تنها امکان اجرای هوش مصنوعی» تعبیر کرد.
مزیت واقعی CUDA در بلوغ ابزارها، گستردگی کتابخانههای بهینهشده، پشتیبانی چارچوبهای نرمافزاری و سرمایهگذاری طولانیمدت توسعهدهندگان و شرکتها روی این اکوسیستم است.
انتقال یک پروژه بزرگ از CUDA به پلتفرم دیگر، بسته به وابستگیهای فنی آن، ممکن است نیازمند تغییر کد، جایگزینی کتابخانهها، تنظیم دوباره عملکرد و آزمایش گسترده باشد.
این موضوع به ایجاد هزینه مهاجرت و وابستگی اکوسیستمی کمک میکند؛ هرچند میزان آن برای تمام پروژهها یکسان نیست.
آیا CUDA بهتنهایی عامل رشد هوش مصنوعی بوده است؟
خیر. رشد هوش مصنوعی نتیجه همزمان چند تحول بوده است: پیشرفت الگوریتمها، افزایش حجم دادهها، توسعه سختافزارهای محاسباتی، معماری شبکههای عصبی و بهبود ابزارهای نرمافزاری.
CUDA در این میان نقش مهمی در دسترسپذیرکردن و بهینهسازی توان GPUهای انویدیا داشته است.
برای مثال، بدون پیشرفت الگوریتمهای یادگیری عمیق، افزایش توان پردازشی بهتنهایی مدلهای امروزی را ایجاد نمیکرد.
از طرف دیگر، بدون زیرساخت محاسباتی مناسب، آموزش بسیاری از مدلهای بزرگ بسیار پرهزینهتر یا دشوارتر میشد.
بنابراین رابطه CUDA و هوش مصنوعی را باید نوعی تقویت متقابل سختافزار، نرمافزار و الگوریتم دانست.
جمعبندی؛ چرا CUDA هنوز اهمیت دارد؟
در رقابت هوش مصنوعی، تنها داشتن سریعترین تراشه کافی نیست. توسعهدهندگان باید بتوانند از آن تراشه بهصورت مؤثر استفاده کنند، مدلهای خود را آموزش دهند، برنامهها را بهینه کنند و آنها را در مقیاس بزرگ اجرا کنند.
CUDA بخش مهمی از این زنجیره را در اکوسیستم انویدیا فراهم کرده است.
از ضرب ماتریسهای بزرگ گرفته تا استنتاج مدلهای زبانی و هماهنگی پردازشهای چند GPU، مجموعه ابزارهای CUDA و کتابخانههای مرتبط به تبدیل قدرت سختافزاری به توان محاسباتی قابلاستفاده کمک میکنند.
اگر GPU را موتور محاسبات هوش مصنوعی بدانیم، CUDA یکی از مهمترین زیرساختهای نرمافزاری است که امکان استفاده مؤثر از آن موتور را فراهم میکند.
و شاید مهمترین درس موفقیت انویدیا نیز همین باشد: آینده فناوری فقط به ساخت سختافزار قدرتمندتر وابسته نیست؛ به ساخت اکوسیستمی وابسته است که بتواند از آن سختافزار بیشترین استفاده را ببرد.